[AI 에이전트] 3주차 RAG 실습 - 의료급여 PDF로 LangChain RAG 파이프라인 구현하기
LangChain과 pdfplumber로 의료급여 PDF를 파싱하고 OpenAI 임베딩과 Chroma 기반 RAG를 구축해, 표 구조 보존과 검색 전략 개선으로 정확도를 60%에서 80%까지 높였습니다.
이번 시간에는 LangChain을 활용하여 RAG(Retrieval-Augmented Generation) 파이프라인을 직접 구축해 보았습니다.
단순히 RAG 구조를 구현하는 데 그치지 않고, 실제 의료급여 정책 PDF를 외부 지식으로 사용하여 문서를 파싱하고 검색 품질을 단계적으로 개선하는 과정을 정리합니다.
특히 의료급여 문서에는 본인부담률과 예외 조건이 표 형태로 정리되어 있어, PDF를 단순 텍스트로 변환할 경우 행과 열의 관계가 손실되는 문제가 있었습니다.
이를 해결하기 위해 pdfplumber를 이용해 표를 별도로 추출하고 Markdown 형식으로 변환했으며, Golden Dataset을 기반으로 검색 정확도를 정량적으로 평가했습니다.
이론 정리 글
https://velog.io/@hongchee/AI-%EC%97%90%EC%9D%B4%EC%A0%84%ED%8A%B8-3%EC%A3%BC%EC%B0%A8-RAG-1
실습 GitHub
https://github.com/DChanHon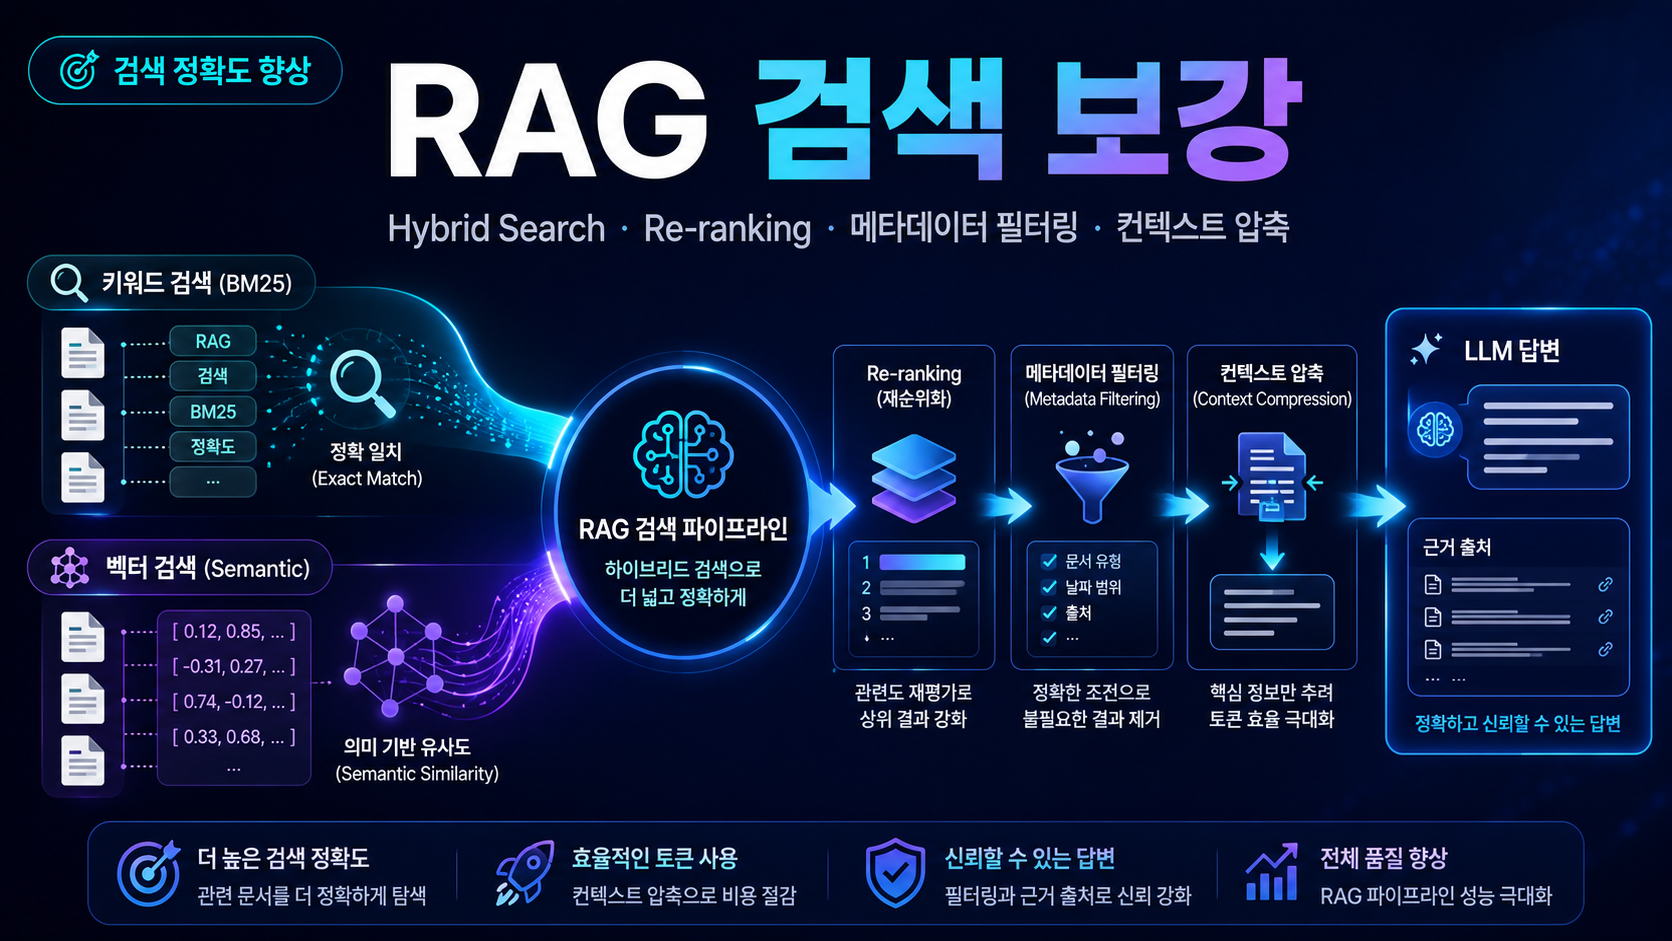
g/aiagent-repo/blob/week-3/DChanHong/week-3/DChanHong/README.md
1. 실습 목표
이번 실습의 목표는 의료급여 PDF 문서를 기반으로 RAG 파이프라인을 구축하고, 검색 결과의 정확도를 평가하며 개선하는 것입니다.
구현한 주요 기능은 다음과 같습니다.
- 의료급여 PDF 문서를
pdfplumber로 불러오기 - PDF의 표를 Markdown 형식으로 변환하여 구조 보존하기
- 일반 텍스트와 표를 별도의
Document로 분리하기 RecursiveCharacterTextSplitter로 문서 청킹하기- OpenAI 임베딩 모델로 문서를 벡터화하기
- Chroma 벡터 데이터베이스에 임베딩 결과 저장하기
- 사용자 질문과 관련된 문서 검색하기
- Gemini를 이용해 검색 문서 기반 답변 생성하기
- Pydantic을 활용해 답변 형식 구조화하기
- Golden Dataset으로 검색 품질 정량 평가하기
- 검색 실패 원인을 분석하고 파싱 및 프롬프트 개선하기
2. 개발 환경
이번 실습에서 사용한 환경은 다음과 같습니다.
| 구분 | 사용 기술 |
|---|---|
| 운영체제 | macOS |
| Python | Python 3.12 이상 |
| 가상 환경 | .venv |
| LLM | Gemini gemini-3-flash-preview |
| LLM 라이브러리 | langchain-google-genai |
| 임베딩 모델 | OpenAI text-embedding-3-small |
| 임베딩 차원 | 1,536차원 |
| 벡터 저장소 | Chroma |
| PDF 파서 | pdfplumber |
| 주요 프레임워크 | LangChain 0.3 이상 |
| 소스 문서 | 2024 알기 쉬운 의료급여제도.pdf |
필요한 라이브러리를 설치합니다.
pip install "langchain>=0.3.0" \
    "langchain-openai>=0.2.0" \
    "langchain-google-genai>=0.0.1" \
    "langchain-community>=0.3.0" \
    "langchain-chroma>=0.1.1" \
    "chromadb>=0.5.0" \
    "pdfplumber>=0.11.0" \
    "python-dotenv>=1.0.0"
API 키는 .env 파일을 통해 관리합니다.
OPENAI_API_KEY=YOUR_OPENAI_API_KEY
GEMINI_API_KEY=YOUR_GEMINI_API_KEY
실제 API 키를 코드나 GitHub 저장소에 직접 작성하지 않도록 주의해야 합니다.
3. 프로젝트 구조
프로젝트는 기능별로 설정, 문서 처리, 검색, LLM, 서비스 계층을 분리했습니다.
week-3/DChanHong/
├── src/
│   ├── config/
│   │   └── settings.py
│   ├── core/
│   │   ├── loader.py
│   │   ├── splitter.py
│   │   ├── embedder.py
│   │   ├── retriever.py
│   │   ├── llm.py
│   │   └── prompts.py
│   ├── schemas/
│   │   └── copayment_response.py
│   ├── services/
│   │   └── rag_service.py
│   ├── utils/
│   │   └── logger.py
│   └── pipeline.py
├── test/
│   └── check_retrieval_quality.py
├── result/
│   ├── 1___20260403_210000.json
│   ├── 2___20260403_215727.json
│   └── 3___20260403_221219.json
├── golden_dataset.jsonl
├── main.py
└── requirements.txt
각 파일의 역할은 다음과 같습니다.
| 파일 | 역할 |
|---|---|
settings.py | 모델명, 청크 크기, API 키, 저장 경로 설정 |
loader.py | PDF 텍스트 및 표 추출 |
splitter.py | 문서 청킹 |
embedder.py | 임베딩 생성 및 Chroma 저장 |
retriever.py | 유사도 기반 문서 검색 |
llm.py | Gemini 및 GPT 모델 인스턴스 생성 |
prompts.py | 시스템 프롬프트 구성 |
copayment_response.py | Pydantic 응답 스키마 정의 |
rag_service.py | 검색부터 LLM 호출까지 통합 |
pipeline.py | 인덱싱 파이프라인 실행 |
check_retrieval_quality.py | Golden Dataset 기반 검색 품질 평가 |
golden_dataset.jsonl | 평가용 질문과 기준 정답 저장 |
4. 전체 실행 흐름
이번 프로젝트는 크게 인덱싱 단계와 검색·생성 단계로 나뉩니다.
인덱싱 단계
PDF 로드
→ 표와 텍스트 분리
→ 문서 청킹
→ 임베딩 생성
→ Chroma 벡터 DB 저장
검색 및 생성 단계
사용자 질문 입력
→ 관련 문서 검색
→ 검색 문서를 컨텍스트로 구성
→ 시스템 프롬프트 생성
→ Gemini 호출
→ Pydantic 구조로 답변 반환
5. 설정 관리
settings.py에서는 모델명과 청킹 설정, 저장 경로 등을 환경 변수로 관리합니다.
EMBEDDING_MODEL = os.getenv(
    "EMBEDDING_MODEL",
    "text-embedding-3-small",
)

LLM_MODEL = os.getenv(
    "LLM_MODEL",
    "gemini-3-flash-preview",
)

CHUNK_SIZE = int(
    os.getenv("CHUNK_SIZE", "500")
)

CHUNK_OVERLAP = int(
    os.getenv("CHUNK_OVERLAP", "100")
)

CHROMA_DB_DIR = STORAGE_DIR / "chroma_db"
설정값을 코드 여러 곳에 직접 작성하지 않고 하나의 파일에서 관리하면, 모델이나 청크 크기를 변경할 때 유지보수가 편리합니다.
6. PDF 문서 로드
의료급여 문서에는 종별, 연령별, 진료 유형별 본인부담률이 표 형태로 정리되어 있습니다.
일반적인 PDF Loader로 문서를 불러오면 표의 행과 열이 평탄화되어 서로 다른 수치가 섞일 수 있습니다.
예를 들어 다음과 같은 표가 있다고 가정합니다.
| 구분 | 본인부담률 |
|---|---|
| 일반추나 | 20% |
| 복합추나 | 30% |
표 구조가 손실되면 LLM은 일반추나 20%와 복합추나 30%의 관계를 정확하게 구분하지 못할 수 있습니다.
이를 해결하기 위해 pdfplumber를 사용해 일반 텍스트와 표를 별도로 추출했습니다.
def load_pdf(file_path: str) -> List[Document]:
    documents = []

    with pdfplumber.open(file_path) as pdf:
        for i, page in enumerate(pdf.pages):
            tables = page.extract_tables()

            for t_idx, table in enumerate(tables):
                md_table = table_to_markdown(table)

                if md_table:
                    table_doc = Document(
                        page_content=(
                            f"[Table Data from Page {i + 1}]\n"
                            f"{md_table}"
                        ),
                        metadata={
                            "source": str(file_path),
                            "page": i + 1,
                            "type": "table",
                        },
                    )

                    documents.append(table_doc)

            text = page.extract_text()

            if text:
                text_doc = Document(
                    page_content=text,
                    metadata={
                        "source": str(file_path),
                        "page": i + 1,
                        "type": "text",
                    },
                )

                documents.append(text_doc)

    return documents
표는 type: "table" 메타데이터를 가진 독립적인 Document로 저장합니다.
일반 텍스트 역시 페이지 단위의 Document로 저장합니다.
이렇게 분리하면 표와 본문의 특성을 유지하면서 검색에 활용할 수 있습니다.
7. 표를 Markdown으로 변환
pdfplumber의 extract_tables()는 표를 2차원 리스트 형태로 반환합니다.
이를 검색과 LLM 처리에 적합한 Markdown 표로 변환했습니다.
def table_to_markdown(
    table: List[List[str]],
) -> str:
    md = []

    md.append(
        "| "
        + " | ".join(clean_table[0])
        + " |"
    )

    md.append(
        "| "
        + " | ".join(
            ["---"] * len(clean_table[0])
        )
        + " |"
    )

    for row in clean_table[1:]:
        md.append(
            "| "
            + " | ".join(row)
            + " |"
        )

    return "\n".join(md)
변환된 표는 다음과 같은 형태로 저장됩니다.
| 구분 | 본인부담률 |
| --- | --- |
| 일반추나 | 20% |
| 복합추나 | 30% |
표를 독립된 문서로 저장하면 특정 조건과 수치 사이의 관계를 비교적 명확하게 유지할 수 있습니다.
8. 문서 청킹
문서가 너무 크면 하나의 청크에 서로 다른 규정이나 수치가 함께 포함될 수 있습니다.
초기에는 chunk_size=1000, chunk_overlap=200을 사용했지만, 의료급여 문서의 표와 세부 규정을 더 정밀하게 구분하기 위해 청크 크기를 줄였습니다.
최종 설정은 다음과 같습니다.
| 설정 | 값 | 이유 |
|---|---|---|
chunk_size | 500 | 특정 규정과 표 데이터에 집중 |
chunk_overlap | 100 | 청크 경계에서 문맥이 끊기는 문제 방지 |
separators | 문단, 줄, 문장, 공백 | 자연스러운 순서로 문서 분할 |
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=100,
    length_function=len,
    separators=[
        "\n\n",
        "\n",
        ". ",
        " ",
        "",
    ],
)

chunks = text_splitter.split_documents(
    documents
)
표는 Loader 단계에서 이미 독립된 Document로 분리했기 때문에, 일반 텍스트와 섞여 표의 구조가 손실되는 문제를 줄일 수 있었습니다.
9. 임베딩 생성
문서 청크를 의미 기반으로 검색하기 위해 OpenAI의 text-embedding-3-small 모델을 사용했습니다.
def get_embeddings() -> OpenAIEmbeddings:
    return OpenAIEmbeddings(
        model="text-embedding-3-small",
        openai_api_key=OPENAI_API_KEY,
    )
text-embedding-3-small 모델은 텍스트를 1,536차원의 벡터로 변환합니다.
문장 의미가 비슷할수록 벡터 공간에서도 가까운 위치에 배치되므로, 질문과 관련된 문서를 검색할 수 있습니다.
10. Chroma 벡터 저장소 생성
생성된 임베딩은 Chroma 벡터 데이터베이스에 저장했습니다.
def create_vector_store(
    documents: List[Document],
) -> Chroma:
    embeddings = get_embeddings()

    vector_store = Chroma.from_documents(
        documents=documents,
        embedding=embeddings,
        persist_directory=str(
            CHROMA_DB_DIR
        ),
    )

return vector_storepersist_directory를 지정하면 Chroma 데이터가 로컬 디렉터리에 저장됩니다.
이후 프로그램을 다시 실행할 때 기존 벡터 저장소를 불러올 수 있으므로, 동일한 문서를 매번 다시 임베딩하지 않아도 됩니다.
인덱싱 파이프라인은 다음 명령어로 실행합니다.
python main.py \
    --source "../data/2024 알기 쉬운 의료급여제도.pdf"
11. Golden Dataset 구성
검색 품질을 정량적으로 평가하기 위해 Golden Dataset을 만들었습니다.
Golden Dataset에는 다음 정보가 포함됩니다.
- 사용자 질문
- 예상 정답
- 정답의 근거가 되는 문서 섹션
- 정답을 판단하는 조건
- 문제 난이도
의료급여 PDF를 직접 확인하여 총 5개의 평가 질문을 구성했습니다.
| ID | 질문 요약 | 정답 | 근거 | 난이도 |
|---|---|---|---|---|
q01 | 65세 이상 1종 수급권자의 틀니 본인부담률 | 5% | 04번 표 | 쉬움 |
q02 | 2종 수급권자의 상급종합병원 외래 본인부담률 | 15% | 01번 표 | 쉬움 |
q03 | 2종 수급권자 10세 아동의 입원 진료비와 식대 부담률 | 진료비 3%, 식대 20% | Q51 | 보통 |
q04 | 1종 수급권자의 복합추나 본인부담률 | 30% | 05번 표 | 보통 |
q05 | 1종 선택의료급여기관 이용자의 응급상황 타 기관 외래 본인부담금 | 면제 | 07번, Q19 | 어려움 |
q05는 일반 규칙과 예외 조항을 함께 판단해야 하는 가장 어려운 질문입니다.
일반적으로 선택의료급여기관 이외의 기관을 이용하면 본인부담금이 발생할 수 있지만, 응급상황에서는 예외적으로 면제 규정이 적용됩니다.
따라서 단순히 가장 유사한 문장만 검색하는 것이 아니라, 일반 규칙과 예외 조항의 관계를 함께 판단해야 합니다.
12. Retriever 구성
Chroma에서 질문과 의미적으로 가까운 문서를 검색합니다.
def get_relevant_documents(
    query: str,
    k: int = 5,
) -> List[Document]:
    vector_store = load_vector_store()

    documents = (
        vector_store.similarity_search(
            query,
            k=k,
        )
    )

return documentssimilarity_search()는 질문과 가장 유사한 문서 청크를 k개 반환합니다.
k 값이 작으면 핵심 문서를 놓칠 수 있고, 너무 크면 관련 없는 문서가 함께 포함될 수 있습니다.
최종 RAG 서비스에서는 예외 조항이 포함될 가능성을 높이기 위해 k=15로 설정했습니다.
13. 시스템 프롬프트 구성
초기에는 단순히 검색 문서를 참고하여 답변하라는 프롬프트를 사용했습니다.
하지만 일반 규칙과 예외 조항이 함께 검색되면, 모델이 더 길고 자주 등장하는 일반 규칙을 선택하는 문제가 발생했습니다.
이를 개선하기 위해 다음 두 가지 지침을 추가했습니다.
조건 분석 단계
_COT_INSTRUCTION = """
당신은 의료급여 본인부담률 질문에 대해
Golden Dataset 형식의 구조화된 답변을
생성하는 보조 도구입니다.

내부 판단 단계:
1. 질문에서 핵심 조건을 추출합니다.
2. 참조 데이터에서 조건에 맞는 섹션을 찾습니다.
3. 해당 데이터에서 정답 수치를 확인합니다.
4. 근거가 된 문장을 그대로 발췌합니다.
"""
예외 조항 우선 적용
질문에 응급상황, 수급권자 종별,
선택의료급여기관과 같은 구체적인 조건이 있다면
해당 조건에 맞는 예외 조항과 단서 조항을
일반 규칙보다 우선하여 적용합니다.
프롬프트에서 답변 절차를 명시하면 모델이 질문의 조건과 근거 문장을 단계적으로 확인하도록 유도할 수 있습니다.
14. Pydantic 구조화 출력
LLM이 자유 형식으로 답변하면 평가 결과를 자동으로 비교하기 어렵습니다.
따라서 Pydantic 모델을 정의하고 with_structured_output()을 사용하여 출력 형식을 강제했습니다.
class CopaymentResponse(BaseModel):
    question: str
    expected_answer: str
    source_section: str
    evidence_text: str
    conditions: List[str]
각 필드의 의미는 다음과 같습니다.
| 필드 | 설명 |
|---|---|
question | 사용자 질문 |
expected_answer | 최종 답변 |
source_section | 근거가 된 PDF 섹션 |
evidence_text | 근거 원문 |
conditions | 정답 판단에 사용한 조건 |
구조화 출력을 사용하면 각 평가 결과를 동일한 JSON 구조로 저장하고 Golden Dataset과 자동으로 비교할 수 있습니다.
15. RAG 서비스 구성
검색부터 LLM 호출까지의 흐름은 rag_service.py에서 통합했습니다.
def ask_question(
    question: str,
) -> CopaymentResponse:
    documents = get_relevant_documents(
        question,
        k=15,
    )

    context_text = "\n".join(
        [
            doc.page_content
            for doc in documents
        ]
    )

    system_prompt = (
        build_rag_system_prompt(
            context_text
        )
    )

    llm = get_llm(
        temperature=0.1
    )

    structured_llm = (
        llm.with_structured_output(
            CopaymentResponse
        )
    )

    messages = [
        SystemMessage(
            content=system_prompt
        ),
        HumanMessage(
            content=f"질문: {question}"
        ),
    ]

    response = structured_llm.invoke(
        messages
    )

    return response
전체 실행 흐름은 다음과 같습니다.
사용자 질문
→ Chroma 문서 검색
→ 상위 15개 청크 반환
→ 검색 문서로 컨텍스트 구성
→ 시스템 프롬프트 생성
→ Gemini 호출
→ CopaymentResponse 반환temperature=0.1로 설정하여 답변의 변동성을 줄였습니다.
16. 검색 품질 개선 실험
총 세 차례의 실험을 진행했습니다.
1차 실험
초기 설정은 다음과 같습니다.
| 항목 | 설정 |
|---|---|
| PDF Loader | PyPDFLoader |
| 검색 문서 수 | k=5 |
chunk_size | 1,000 |
chunk_overlap | 200 |
평가 결과는 다음과 같습니다.
| 질문 | AI 응답 | 기준 정답 | 결과 |
|---|---|---|---|
q01 | 5% | 5% | 성공 |
q02 | 15% | 15% | 성공 |
q03 | 진료비 3%, 식대 20% | 진료비 3%, 식대 20% | 성공 |
q04 | 20% | 30% | 실패 |
q05 | 본인부담금 발생 | 면제 | 실패 |
정답 수: 3개
전체 문제: 5개
성공률: 60%
1차 실험 실패 원인
q04에서는 일반추나 20%와 복합추나 30%가 동일한 표 안에 있었습니다.
PyPDFLoader로 표를 일반 텍스트처럼 추출하면서 행과 열의 관계가 손실되었고, 모델은 더 자주 등장한 20%를 선택했습니다.
q05에서는 Top-5 검색 결과에 일반적인 유료 규정이 다수 포함되었고, 상대적으로 짧게 작성된 응급상황 면제 조항은 포함되지 않았습니다.
2차 실험
두 번째 실험에서는 다음과 같이 변경했습니다.
| 항목 | 변경 사항 |
|---|---|
| PDF Loader | pdfplumber |
| 표 처리 | Markdown 표로 별도 추출 |
| 검색 문서 수 | k=10 |
chunk_size | 500 |
chunk_overlap | 100 |
평가 결과는 다음과 같습니다.
| 질문 | 1차 결과 | 2차 결과 | 2차 응답 | 정답 |
|---|---|---|---|---|
q01 | 성공 | 성공 | 5% | 5% |
q02 | 성공 | 성공 | 15% | 15% |
q03 | 성공 | 성공 | 진료비 3%, 식대 20% | 진료비 3%, 식대 20% |
q04 | 실패 | 성공 | 30% | 30% |
q05 | 실패 | 실패 | 본인부담금 발생 | 면제 |
정답 수: 4개
전체 문제: 5개
성공률: 80%q04는 표를 Markdown으로 분리하면서 복합추나 30%라는 행과 열의 관계가 보존되어 정답을 찾을 수 있었습니다.
반면 q05는 검색 결과에 면제 조항과 유료 규정이 함께 포함되었지만, 모델이 더 길게 설명된 일반 유료 규칙을 선택했습니다.
이는 더 자주 등장하거나 길게 설명된 정보에 판단이 치우치는 Anchor Bias와 유사한 문제로 볼 수 있습니다.
3차 실험
세 번째 실험에서는 다음 내용을 추가했습니다.
- 검색 문서 수를
k=15로 증가 - 질문의 핵심 조건을 분석하는 프롬프트 추가
- 구체적인 예외 조항을 일반 규칙보다 우선하도록 지시
평가 결과는 다음과 같습니다.
| 질문 | 2차 결과 | 3차 결과 |
|---|---|---|
q01 | 성공 | 성공 |
q02 | 성공 | 성공 |
q03 | 성공 | 성공 |
q04 | 성공 | 성공 |
q05 | 실패 | 실패 |
q05에 대한 실제 응답은 다음과 같았습니다.
아니요. 본인부담금이 발생합니다.
본인부담금은 1,000원에서 2,000원입니다.
하지만 기준 정답은 면제였습니다.
검색 문서 수를 늘리고 예외 조항 우선순위 프롬프트를 적용했음에도, 모델은 응급상황 규정이 아닌 의뢰를 통한 타 기관 이용 규정을 근거로 선택했습니다.
최종 성공률은 여전히 80%였습니다.
17. 실습 중 발생한 문제
문제 1. 복합추나 본인부담률 오답
의료급여 PDF에는 일반추나와 복합추나의 본인부담률이 같은 표에 정리되어 있습니다.
일반추나: 20%
복합추나: 30%
초기 PDF 파싱 방식에서는 표의 구조가 깨지면서 두 수치가 동일한 문맥에 섞였습니다.
그 결과 모델은 복합추나 질문에 일반추나의 본인부담률인 20%를 답했습니다.
해결 방법
PyPDFLoader대신pdfplumber사용extract_tables()로 표를 별도 추출- 추출한 표를 Markdown으로 변환
- 표를 독립적인
Document로 저장 chunk_size를 1,000에서 500으로 감소
이를 통해 q04의 답변이 20%에서 30%로 개선되었습니다.
문제 2. 응급상황 예외 조항 검색 실패
q05는 선택의료급여기관 이용자가 응급상황에서 다른 의료기관을 이용할 때 본인부담금이 면제되는지를 묻는 질문입니다.
문서에는 다음과 같은 규칙들이 함께 존재합니다.
일반 규칙:
선택의료급여기관 외 기관 이용 시
본인부담금이 발생할 수 있음

예외 규칙:
응급상황에서는
본인부담금이 면제될 수 있음
두 문장은 선택의료급여기관과 타 의료기관 이용이라는 키워드를 공유하지만 결론은 정반대입니다.
벡터 검색에서는 의미적으로 비슷한 일반 규정이 높은 순위에 배치되었고, 응급상황 면제 조항은 일관되게 상위에 포함되지 않았습니다.
k=15까지 증가시키고 프롬프트를 개선했지만 최종 결과에서는 해결되지 않았습니다.
이는 벡터 유사도 검색만으로 모든 규정과 예외 관계를 처리하기 어렵다는 점을 보여줍니다.
18. 실습을 통해 확인한 점
데이터 파싱이 검색 품질의 기반이다
이번 실습에서 가장 큰 성능 향상은 LLM 모델을 변경하거나 복잡한 프롬프트를 적용했을 때가 아니었습니다.
PyPDFLoader에서 pdfplumber로 변경하고 표를 구조적으로 보존했을 때 정확도가 60%에서 80%로 향상되었습니다.
이는 검색 이전 단계에서 문서의 정보 구조가 손실되면, 이후 임베딩과 LLM의 성능이 뛰어나도 정확한 답변을 만들기 어렵다는 의미입니다.
검색 문서 수와 노이즈는 상충 관계가 있다
k 값을 높이면 정답 문서가 검색 결과에 포함될 가능성이 증가합니다.
하지만 관련 없는 문서도 함께 포함되므로 컨텍스트의 노이즈가 증가합니다.
k가 작음
→ 핵심 문서를 놓칠 가능성 증가

k가 큼
→ 관련 없는 문서와 상충하는 규칙이 증가
따라서 검색 문서 수를 단순히 늘리는 것만으로는 문제를 해결하기 어렵습니다.
검색 이후 관련 문서를 다시 정렬하거나 압축하는 과정이 필요합니다.
구조화 출력은 자동 평가를 가능하게 한다
with_structured_output(CopaymentResponse)를 사용하면 모든 답변이 동일한 필드 구조로 반환됩니다.
question
expected_answer
source_section
evidence_text
conditions
이를 통해 Golden Dataset의 정답과 자동으로 비교할 수 있었습니다.
자유 형식의 자연어 답변이었다면 답변마다 표현이 달라져 자동화된 정답 비교가 어려웠을 것입니다.
19. 개선해 보고 싶은 부분
Hybrid Search
현재는 임베딩 기반 벡터 검색만 사용하고 있습니다.
q05처럼 응급, 면제와 같은 특정 키워드가 정답을 결정하는 질문에서는 BM25와 벡터 검색을 함께 사용하는 Hybrid Search가 더 적합할 수 있습니다.
BM25 키워드 검색
+
벡터 유사도 검색
=
Hybrid Search
BM25는 정확한 단어 일치에 강하고, 벡터 검색은 의미적 유사성에 강합니다.
두 방식을 결합하면 예외 조항의 키워드를 놓치는 문제를 줄일 수 있습니다.
메타데이터 필터링
현재 표와 일반 텍스트는 다음과 같은 메타데이터로 구분되어 있습니다.
{
    "type": "table"
}
본인부담률처럼 표에 정리된 정보를 묻는 질문은 type="table"인 문서를 우선 검색하도록 구성할 수 있습니다.
페이지 번호, 섹션명, 문서 유형 등의 메타데이터를 추가하면 검색 범위를 더 정밀하게 제한할 수 있습니다.
Re-ranking
1차 검색 결과를 Cross-Encoder와 같은 Re-ranker에 전달하여 질문과의 관련성을 다시 계산할 수 있습니다.
벡터 검색으로 후보 문서 검색
→ Re-ranker로 관련성 재평가
→ 상위 문서만 LLM에 전달
이를 통해 자주 등장하는 일반 규칙보다 질문의 구체적인 조건과 일치하는 예외 조항을 상위로 올릴 수 있습니다.
컨텍스트 압축
k=15로 검색하면 정답 문서가 포함될 가능성은 높아지지만, 컨텍스트의 양과 노이즈도 증가합니다.
ContextualCompressionRetriever를 이용해 검색된 문서에서 질문과 관련된 문장만 추출하면 LLM이 잘못된 근거를 선택하는 문제를 줄일 수 있습니다.
출처 표시
현재는 답변에 source_section만 반환합니다.
다음과 같은 정보를 함께 반환하면 사용자가 직접 원문을 확인할 수 있습니다.
- PDF 파일명
- 페이지 번호
- 표 또는 텍스트 여부
- 근거 섹션
- 실제 근거 문장
출처를 명확하게 표시하면 RAG 답변의 신뢰성을 높일 수 있습니다.
20. 느낀 점
RAG를 처음 구현하면서 가장 예상하지 못했던 부분은 LLM 모델보다 PDF 파싱 방식이 검색 품질에 더 직접적인 영향을 준다는 점이었습니다.
처음에는 모델이나 프롬프트를 개선하면 정확도가 크게 높아질 것이라고 생각했습니다.
하지만 실제로는 PDF의 표 구조를 보존하는 것만으로 정확도가 60%에서 80%로 향상되었습니다.
이는 검색 단계에 들어가기 전부터 데이터의 구조와 의미가 제대로 보존되어야 한다는 점을 보여줍니다.
또한 q05 문제를 끝까지 해결하지 못하면서 벡터 유사도 검색이 모든 문제를 해결할 수 없다는 점도 확인했습니다.
응급상황 면제 조항과 일반 유료 규정은 의미적으로 매우 가까우면서도 결론은 정반대입니다.
이런 문제에서는 벡터 검색만 사용하는 것보다 BM25 기반 키워드 검색, Re-ranking, 메타데이터 필터링과 같은 추가 검색 전략이 필요합니다.
이번 실습을 통해 RAG는 단순히 문서를 임베딩하고 LLM에 전달하는 구조가 아니라, 데이터 파싱부터 검색, 정렬, 프롬프트, 답변 구조화, 평가까지 전체 파이프라인을 함께 개선해야 하는 시스템이라는 점을 알게 되었습니다.
21. 핵심 정리
-
의료급여 PDF를
pdfplumber로 불러오고 일반 텍스트와 표를 별도의Document로 분리했습니다. -
표는 Markdown 형식으로 변환하여 행과 열의 관계가 유지되도록 했습니다.
-
RecursiveCharacterTextSplitter를 사용하고chunk_size=500,chunk_overlap=100으로 설정했습니다. -
OpenAI의
text-embedding-3-small모델로 문서를 임베딩했습니다. -
임베딩 결과를 Chroma 로컬 벡터 데이터베이스에 저장했습니다.
-
Golden Dataset 5문항을 구성하여 검색 및 답변 품질을 정량적으로 평가했습니다.
-
1차 실험에서는 3개 문제를 맞혀 정확도 60%를 기록했습니다.
-
pdfplumber와 표 Markdown 변환을 적용한 후 정확도가 80%로 향상되었습니다. -
q04복합추나 문제는 표 구조를 보존하면서 해결했습니다. -
q05응급상황 면제 문제는k=15와 예외 조항 프롬프트를 적용했지만 해결하지 못했습니다. -
with_structured_output()과 Pydantic을 사용해 답변을 일정한 형식으로 반환했습니다. -
벡터 검색의 한계를 보완하려면 Hybrid Search, Re-ranking, 메타데이터 필터링과 컨텍스트 압축이 필요합니다.
참고 자료