[AI 에이전트] 5주차 RAG 평가 실습 - Ragas 5대 메트릭으로 Basic부터 Metadata-Full까지 진단하기
Ragas로 4가지 RAG 파이프라인(Basic/Hybrid/Rerank/Metadata-Full)을 15문항 Golden Dataset 기준으로 5개 메트릭으로 평가했습니다. "정보 없음" 폴백 4건 회복, q09 추나요법 Advanced 파괴, q15 cross-y...
4주차에서는 Basic RAG, Hybrid Search, Rerank, Metadata-Full이라는 네 가지 RAG 파이프라인을 구현했습니다.
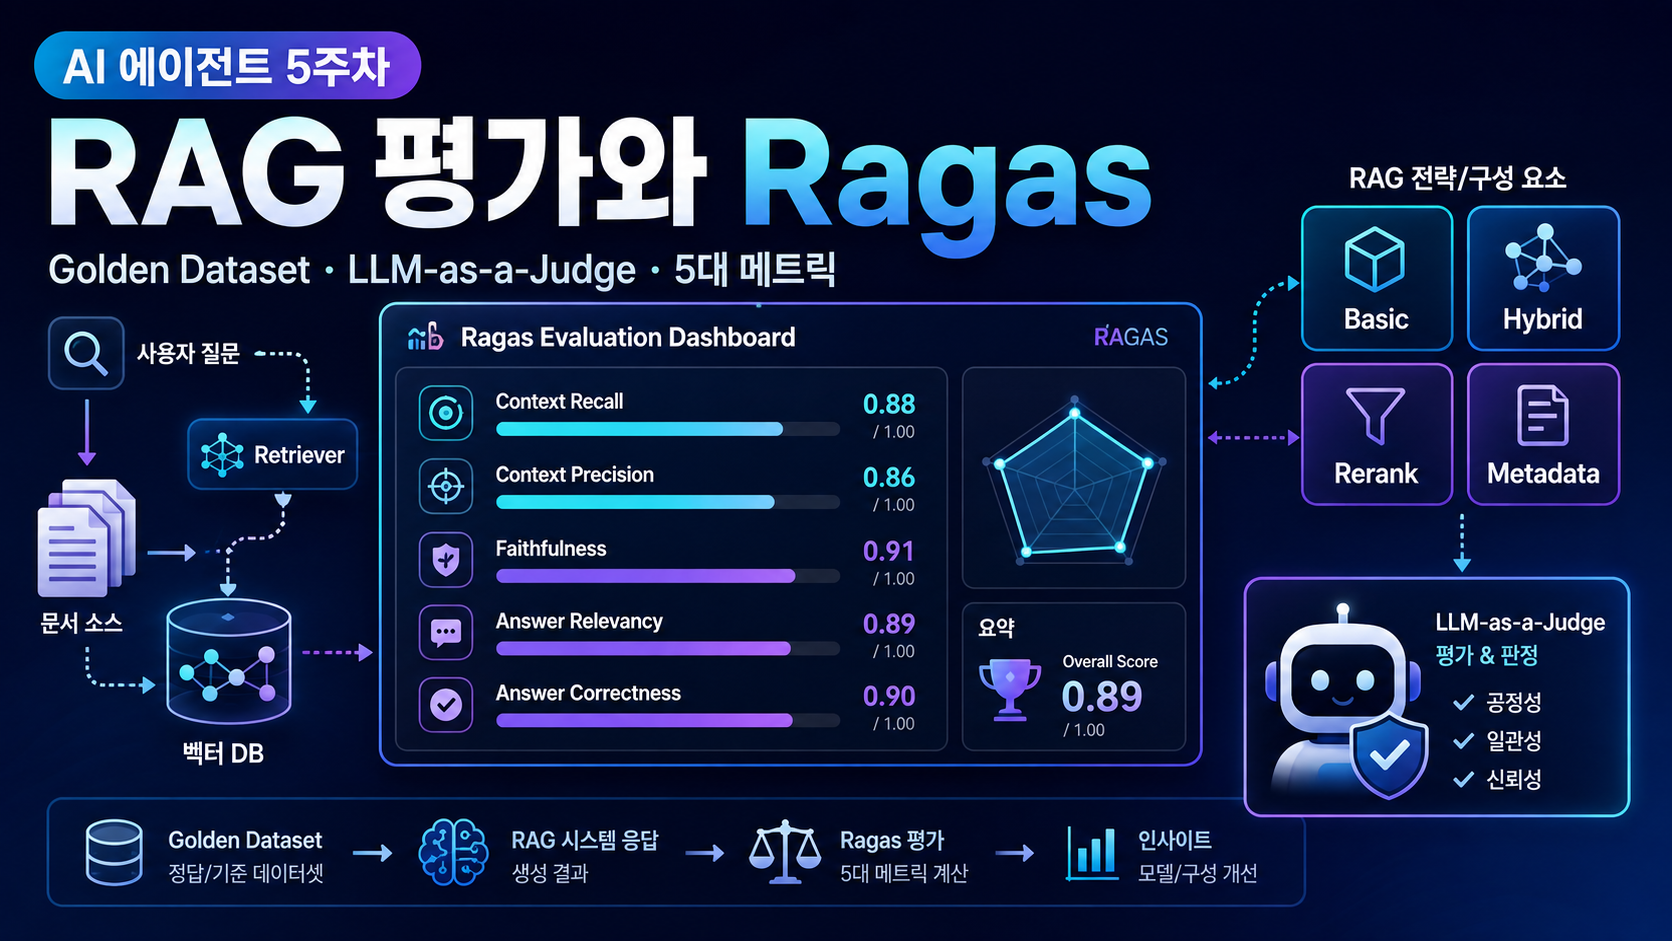
이번 5주차 실습에서는 이 파이프라인들을 단순한 정답과 오답 기준이 아니라, Ragas가 제공하는 5가지 메트릭으로 정량 평가했습니다.
Advanced 기법을 추가하면 항상 성능이 좋아질 것이라는 예상이 실제 메트릭에서도 동일하게 나타나는지 확인하고, 수동 채점만으로는 발견하기 어려웠던 검색 및 생성 단계의 실패 패턴을 분석했습니다.
실습 GitHub
https://github.com/DChanHong/aiagent-repo/blob/week-5/DChanhong/week-5/DChanhong/README.md
1. 실습 목표
이번 실습의 목표는 4주차에서 구현한 네 가지 RAG 파이프라인을 동일한 데이터셋과 메트릭으로 평가하는 것입니다.
평가 대상은 다음과 같습니다.
-
Basic RAG
-
Hybrid RAG
-
Rerank RAG
-
Metadata-Full RAG
주요 실습 내용은 다음과 같습니다.
- 동일한 15개 문항으로 네 가지 RAG 변형 평가
- Ragas 클래스형 메트릭 5개 적용
- 검색 단계와 생성 단계의 품질 분리 분석
- 수동으로 작성한
ground_truth_contexts를 포함한 Golden Dataset 구성 - 난이도별 평가 결과 비교
- 문항별 실패 원인 분석
- Ragas 메트릭 간 충돌 사례 확인
- 다년도 문서와 표 데이터 평가의 한계 분석
2. 개발 환경
| 구분 | 사용 기술 |
|---|---|
| 운영체제 | macOS |
| Python | Python 3.x |
| 생성용 LLM | Google gemini-3-flash-preview |
| 평가용 LLM | OpenAI gpt-4o-mini |
| 평가용 임베딩 | OpenAI text-embedding-3-small |
| 벡터 저장소 | ChromaDB |
| 컬렉션 | medical_aid_unified |
| Ragas | 0.4.x |
| Re-ranker | Cohere rerank-multilingual-v3.0 |
| BM25 토크나이저 | kiwipiepy Kiwi 형태소 분석기 |
| PDF 데이터 | 2016년부터 2026년까지 의료급여제도 PDF 11개 |
| Golden Dataset | 15문항 |
| Golden Dataset 파일 | data/golden_dataset_v2.jsonl |
API 키는 .env 파일로 관리합니다.
OPENAI_API_KEY=YOUR_OPENAI_API_KEY
GEMINI_API_KEY=YOUR_GEMINI_API_KEY
COHERE_API_KEY=YOUR_COHERE_API_KEY
실제 API 키는 코드나 GitHub 저장소에 직접 작성하지 않습니다.
3. 프로젝트 구조
week-5/DChanhong/
├── THEORY.md
├── README.md
├── data/
│   └── golden_dataset_v2.jsonl
├── pdf/
│   └── 2016~2026 의료급여제도 PDF
├── chroma_db/
├── indexing.py
├── evaluate_ragas.py
└── assignment/
    ├── basic/
    │   ├── src/domains/rag/service.py
    │   └── data/basic/0/
    │       ├── MEMO.md
    │       ├── evaluation_results.jsonl
    │       └── ragas_scores.csv
    ├── hybrid/
    │   └── data/hybrid/0/
    │       ├── MEMO.md
    │       ├── evaluation_results.jsonl
    │       └── ragas_scores.csv
    ├── rerank/
    │   └── data/rerank/0/
    │       ├── MEMO.md
    │       ├── evaluation_results.jsonl
    │       └── ragas_scores.csv
    └── metadata-full/
        ├── src/utils/year_extractor.py
        └── data/metadata-full/0/
            ├── MEMO.md
            ├── evaluation_results.jsonl
            └── ragas_scores.csv
주요 파일의 역할은 다음과 같습니다.
| 파일 | 역할 |
|---|---|
indexing.py | PDF 로드, 청킹, 임베딩, ChromaDB 저장 |
evaluate_ragas.py | Ragas 평가 데이터 변환 및 메트릭 계산 |
golden_dataset_v2.jsonl | 평가 질문, 기준 답안, 기준 컨텍스트 저장 |
evaluation_results.jsonl | 각 RAG 파이프라인의 질문별 실행 결과 |
ragas_scores.csv | Ragas 메트릭 평가 결과 |
MEMO.md | 변형별 실행 과정과 결과 분석 |
year_extractor.py | 질문에서 연도 조건 추출 |
4. 평가 대상 RAG 파이프라인
| 변형 | 검색 방식 | 추가 기법 |
|---|---|---|
| Basic | Chroma Dense Search Top-10 | 없음 |
| Hybrid | Dense Top-20 + BM25 Top-20 | RRF로 융합 후 Top-10 |
| Rerank | Dense 20 + BM25 20 | Cohere Re-ranking 후 Top-10 |
| Metadata-Full | 연도 Pre-filter 후 Dense + BM25 | Cohere Re-ranking 후 Top-10 |
4주차 실습에서는 최종 답변이 정답인지 오답인지를 중심으로 평가했습니다.
5주차에서는 각 변형이 생성한 evaluation_results.jsonl을 Ragas 평가 스크립트에 전달하여 검색과 생성 품질을 여러 메트릭으로 나누어 분석했습니다.
질문
→ RAG 파이프라인 실행
→ 검색 문서와 생성 답변 저장
→ Ragas 평가 데이터셋 변환
→ 5개 메트릭 계산
→ CSV 결과 저장
→ 변형별 결과 비교
5. Golden Dataset 구성
이번 실습에서는 golden_dataset_v2.jsonl에 총 15개의 평가 문항을 구성했습니다.
각 문항은 다음 필드를 가집니다.
| 필드 | 의미 | Ragas 매핑 |
|---|---|---|
id | 문항 ID | 분석용 |
question | 사용자 질문 | user_input |
ground_truth | 기준 답안 | reference |
ground_truth_contexts | 기준 근거 문장 | reference_contexts |
difficulty | 문항 난이도 | 난이도별 분석 |
source_year | 정답 문서의 연도 | 연도 혼동 분석 |
난이도 분포는 다음과 같습니다.
| 난이도 | 문항 수 | 특징 |
|---|---|---|
| Easy | 4 | 단년도 단일 정보 검색 |
| Medium | 4 | 단년도 다항목 및 예외 조항 |
| Hard | 3 | 표 추론 및 연도 조건 해석 |
| Cross-year | 4 | 두 개 연도 이상의 정보 비교 |
Cross-year 문항은 source_year가 2025+2026과 같은 형식으로 저장됩니다.
ground_truth_contexts에도 비교 대상이 되는 두 연도의 근거 문장을 모두 포함했습니다.
대표 문항은 다음과 같습니다.
| ID | 난이도 | 연도 | 질문 요약 | 기준 답안 |
|---|---|---|---|---|
q02 | Easy | 2024 | 1종 수급권자의 CT·MRI·PET 본인부담률 | 5% |
q09 | Hard | 2026 | 디스크 외 질환의 단순·특수추나 본인부담률 | 80% |
q12 | Cross-year | 2025+2026 | 정신과 폐쇄병동 가산율 변화 | 2025년 12%, 2026년 16% |
q13 | Cross-year | 2024+2025 | 노숙인진료시설 고시 유효기간 변화 | 1년에서 3년으로 연장 |
q15 | Cross-year | 2018+2026 | 장기지속형 주사제 본인부담률 비교 | 2018년 10%, 2026년 2% |
Golden Dataset은 다음 원칙으로 작성했습니다.
ground_truth는 연도, 대상, 조건, 값을 포함한 완전한 문장으로 작성ground_truth_contexts는 PDF 원문에서 직접 발췌- 기준 근거를 LLM으로 자동 생성하지 않음
- 표 데이터는 헤더와 셀의 관계를 알 수 있도록 문장 형태로 정리
- Cross-year 문항은 비교 대상 연도의 근거를 모두 포함
6. Ragas 평가 데이터셋 변환
각 RAG 변형의 실행 결과는 evaluation_results.jsonl에 저장됩니다.
evaluate_ragas.py는 해당 파일을 읽어 Ragas의 SingleTurnSample 목록으로 변환합니다.
def load_dataset(
    jsonl_path: Path,
    limit: int | None,
) -> EvaluationDataset:
    samples: List[SingleTurnSample] = []

    with open(
        jsonl_path,
        "r",
        encoding="utf-8",
    ) as file:
        for index, line in enumerate(file):
            if limit is not None and index >= limit:
                break

            data = json.loads(line)

            samples.append(
                SingleTurnSample(
                    user_input=data["question"],
                    response=data.get(
                        "response",
                        "",
                    ),
                    retrieved_contexts=data.get(
                        "retrieved_contexts",
                        [],
                    ) or [],
                    reference=data.get(
                        "ground_truth",
                        "",
                    ) or "",
                    reference_contexts=data.get(
                        "ground_truth_contexts",
                        [],
                    ) or [],
                )
            )

    return EvaluationDataset(
        samples=samples
    )
필드 매핑은 다음과 같습니다.
| 실행 결과 필드 | Ragas 필드 |
|---|---|
question | user_input |
retrieved_contexts | retrieved_contexts |
response | response |
ground_truth | reference |
ground_truth_contexts | reference_contexts |
데이터셋 변환 후 evaluate()를 호출합니다.
result = evaluate(
    dataset=dataset,
    metrics=metrics,
    llm=evaluator_llm,
    embeddings=evaluator_emb,
)

dataframe = result.to_pandas()

dataframe.to_csv(
    output_path,
    index=False,
    encoding="utf-8",
)
평가 결과는 변형별 ragas_scores.csv에 저장합니다.
7. 평가 메트릭 구성
이번 실습에서는 Ragas의 클래스형 메트릭 5개를 사용했습니다.
metrics = [
    ContextRecall(
        llm=evaluator_llm
    ),
    LLMContextPrecisionWithReference(
        llm=evaluator_llm
    ),
    Faithfulness(
        llm=evaluator_llm
    ),
    ResponseRelevancy(
        llm=evaluator_llm,
        embeddings=evaluator_emb,
    ),
    AnswerCorrectness(
        llm=evaluator_llm,
        embeddings=evaluator_emb,
    ),
]| 메트릭 | 클래스 | 평가 단계 | 낮을 때 의심할 문제 |
|---|---|---|---|
| Context Recall | ContextRecall | 검색 | 정답에 필요한 문서가 검색되지 않음 |
| Context Precision | LLMContextPrecisionWithReference | 검색 | 관련 없는 문서가 검색 결과에 포함됨 |
| Faithfulness | Faithfulness | 생성 | 답변이 검색 문서의 근거를 벗어남 |
| Answer Relevancy | ResponseRelevancy | 생성 | 답변이 질문의 의도와 관련성이 낮음 |
| Answer Correctness | AnswerCorrectness | 전체 | 생성 답변이 기준 답안과 다름 |
메트릭을 검색과 생성 단계로 구분하면 다음과 같습니다.
검색 품질
├── Context Recall
└── Context Precision

생성 품질
├── Faithfulness
└── Answer Relevancy

전체 품질
└── Answer Correctness
이 구조를 통해 다음과 같은 사례를 분리해서 분석할 수 있습니다.
검색 성공 + 생성 실패
→ Context Recall은 높음
→ Answer Correctness는 낮음

검색 일부 실패 + 부분 정답
→ Context Recall은 낮음
→ Answer Correctness는 일정 점수 유지
8. 평가용 LLM과 임베딩 설정
RAG 답변을 생성하는 모델은 gemini-3-flash-preview입니다.
Ragas 평가에는 별도의 모델인 gpt-4o-mini를 사용했습니다.
DEFAULT_MODEL = "gpt-4o-mini"
DEFAULT_EMBEDDING = (
    "text-embedding-3-small"
)

llm = ChatOpenAI(
    model=DEFAULT_MODEL,
    temperature=0,
    openai_api_key=openai_api_key,
)

embeddings = OpenAIEmbeddings(
    model=DEFAULT_EMBEDDING,
    openai_api_key=openai_api_key,
)

evaluator_llm = LangchainLLMWrapper(
    llm
)

evaluator_emb = (
    LangchainEmbeddingsWrapper(
        embeddings
    )
)
생성 모델과 평가 모델을 분리한 이유는 동일한 모델이 자신의 답변을 평가하면서 발생할 수 있는 자기 선호 편향을 줄이기 위해서입니다.
답변 생성
→ Gemini

답변 평가
→ GPT-4o-mini
9. Ragas 한국어 프롬프트 적용
Ragas의 기본 평가 프롬프트는 영어로 작성되어 있습니다.
한국어 질문과 답변을 평가하기 위해 각 메트릭의 프롬프트를 한국어로 변환했습니다.
async def _adapt_to_korean(
    metrics,
    evaluator_llm,
):
    for metric in metrics:
        try:
            adapted = (
                await metric.adapt_prompts(
                    language="korean",
                    llm=evaluator_llm,
                )
            )

            metric.set_prompts(
                **adapted
            )

        except Exception as error:
            print(
                f"[prompts] "
                f"{metric.__class__.__name__}: "
                f"한국어 변환 실패 "
                f"({error})"
            )
Ragas 0.4.x에서 adapt_prompts()는 비동기로 실행되므로 await를 사용했습니다.
한국어 프롬프트 변환에 실패하더라도 영문 프롬프트를 사용해 평가를 계속 진행하도록 예외 처리를 추가했습니다.
10. 평가 실행
Basic RAG의 평가 명령어는 다음과 같습니다.
cd week-5/DChanhong

python evaluate_ragas.py \
    --input assignment/basic/data/basic/0/evaluation_results.jsonl
전체 실행 전 일부 데이터만 평가하는 파일럿 실행도 가능합니다.
python evaluate_ragas.py \
    --input assignment/basic/data/basic/0/evaluation_results.jsonl \
    --limit 5 \
    --output /tmp/basic_pilot.csv
전체 평가 규모는 다음과 같습니다.
| 항목 | 값 |
|---|---|
| 평가 문항 | 15 |
| 평가 메트릭 | 5 |
| RAG 변형 | 4 |
| 평가 단위 | 300 |
| 변형별 Ragas 평가 시간 | 약 4분 35초 |
| Rerank API 추가 시간 | 약 2분 |
15문항
× 5개 메트릭
× 4개 RAG 변형
= 총 300개 평가 단위
11. 전체 평가 결과
각 변형의 ragas_scores.csv 평균은 다음과 같습니다.
| 메트릭 | Basic | Hybrid | Rerank | Metadata-Full |
|---|---|---|---|---|
| Context Recall | 1.000 | 1.000 | 0.933 | 0.933 |
| Context Precision | 0.778 | 0.879 | 0.941 | 0.922 |
| Faithfulness | 0.554 | 0.780 | 0.837 | 0.714 |
| Answer Relevancy | 0.556 | 0.755 | 0.772 | 0.681 |
| Answer Correctness | 0.637 | 0.699 | 0.698 | 0.696 |
Basic에서 Hybrid로 변경
BM25 키워드 검색이 추가되면서 가장 크게 개선된 메트릭은 Faithfulness였습니다.
Faithfulness
0.554 → 0.780
+0.226
Answer Relevancy도 다음과 같이 상승했습니다.
Answer Relevancy
0.556 → 0.755
+0.199
Basic에서 정보를 찾을 수 없습니다라고 응답했던 문항 중 일부가 BM25 검색을 통해 실제 답변으로 전환된 것이 주요 원인이었습니다.
Hybrid에서 Rerank로 변경
Cohere Re-ranking을 적용한 결과 Context Precision이 가장 높은 0.941을 기록했습니다.
Context Precision
0.879 → 0.941
Faithfulness 역시 0.837로 가장 높은 점수를 기록했습니다.
하지만 Context Recall은 1.000에서 0.933으로 감소했습니다.
Re-ranker가 관련성이 높은 문서를 상위에 배치하는 과정에서 일부 정답 근거 청크를 Top-10 밖으로 밀어낸 사례가 발생했기 때문입니다.
Rerank에서 Metadata-Full로 변경
연도 Pre-filter를 적용했지만 일부 메트릭은 오히려 감소했습니다.
Faithfulness
0.837 → 0.714

Answer Relevancy
0.772 → 0.681
Pre-filter로 후보 문서가 줄어든 상태에서 Re-ranking이 보조 근거 문서까지 제거하면서 LLM이 정보가 기재되어 있지 않습니다와 같은 보수적인 답변을 생성하는 사례가 발생했습니다.
Answer Correctness의 정체
Answer Correctness는 Hybrid 이후 거의 변하지 않았습니다.
Hybrid: 0.699
Rerank: 0.698
Metadata-Full: 0.696
검색 정밀도와 Faithfulness는 Rerank에서 개선되었지만, 최종 답변의 정확도는 BM25가 추가된 Hybrid 단계에서 이미 대부분 개선되었습니다.
추가적인 검색 기법이 모든 메트릭과 최종 정답 정확도를 함께 높이지는 않는다는 점을 확인했습니다.
12. 난이도별 결과
난이도별 Answer Correctness 평균은 다음과 같습니다.
| 난이도 | 문항 수 | Basic | Hybrid | Rerank | Metadata-Full |
|---|---|---|---|---|---|
| Easy | 4 | 0.52 | 0.85 | 0.75 | 0.82 |
| Medium | 4 | 0.75 | 0.76 | 0.83 | 0.75 |
| Hard | 3 | 0.49 | 0.32 | 0.37 | 0.38 |
| Cross-year | 4 | 0.75 | 0.78 | 0.76 | 0.75 |
Easy
Basic RAG는 q02, q03에서 정보를 찾을 수 없습니다라고 답했습니다.
BM25가 CT·MRI·PET, 자연분만 등의 정확한 키워드를 검색하면서 Hybrid의 평균이 0.85로 상승했습니다.
Medium
문맥 추론이 필요한 Medium 문항에서는 Rerank가 0.83으로 가장 높은 결과를 기록했습니다.
Cross-encoder가 검색된 후보 문서와 질문을 직접 비교한 효과로 볼 수 있습니다.
Hard
Hard 문항에서는 모든 Advanced 변형이 Basic보다 낮았습니다.
특히 q09의 Answer Correctness가 Basic 0.98에서 Hybrid 0.03으로 급락하면서 전체 평균을 낮췄습니다.
Cross-year
Cross-year 문항은 모든 변형에서 0.75에서 0.78 사이의 유사한 결과를 기록했습니다.
BM25와 Re-ranking만으로 여러 연도의 정보를 균형 있게 검색하고 합성하는 데 한계가 있었습니다.
13. 문항별 Answer Correctness
| ID | 난이도 | 연도 | Basic | Hybrid | Rerank | Metadata-Full |
|---|---|---|---|---|---|---|
q01 | Easy | 2025 | 0.98 | 0.97 | 0.98 | 0.97 |
q02 | Easy | 2024 | 0.06 | 1.00 | 0.99 | 0.98 |
q03 | Easy | 2026 | 0.05 | 0.81 | 0.50 | 0.73 |
q04 | Easy | 2023 | 1.00 | 0.60 | 0.53 | 0.60 |
q05 | Medium | 2024 | 0.95 | 0.63 | 0.54 | 0.35 |
q06 | Medium | 2025 | 0.99 | 0.72 | 0.99 | 0.98 |
q07 | Medium | 2025 | 0.99 | 0.99 | 0.99 | 0.99 |
q08 | Medium | 2024 | 0.06 | 0.67 | 0.79 | 0.69 |
q09 | Hard | 2026 | 0.98 | 0.03 | 0.19 | 0.15 |
q10 | Hard | 2024 | 0.05 | 0.52 | 0.52 | 0.47 |
q11 | Hard | 2023 | 0.44 | 0.41 | 0.41 | 0.51 |
q12 | Cross-year | 2025+2026 | 0.95 | 0.79 | 0.95 | 0.95 |
q13 | Cross-year | 2024+2025 | 0.96 | 0.96 | 0.79 | 0.57 |
q14 | Cross-year | 2025+2026 | 0.74 | 0.74 | 0.93 | 0.85 |
q15 | Cross-year | 2018+2026 | 0.37 | 0.63 | 0.37 | 0.64 |
Advanced 기법을 적용한 후 회복된 문항도 있었지만, 반대로 Basic보다 성능이 낮아진 문항도 확인할 수 있었습니다.
14. 실패 사례 A: Advanced가 Basic보다 악화된 q09
질문
2026년 의료급여 1종 수급권자가
디스크·협착증 외 질환으로
단순추나 또는 특수추나 치료를 받을 때
본인부담률은 몇 퍼센트인가요?
기준 답안
2026년 의료급여 1종 수급권자가
디스크·협착증 외 질환으로
단순추나 또는 특수추나 치료를 받을 때
본인부담률은 80%입니다.
변형별 결과
| 변형 | Correctness | Faithfulness | Relevancy | 응답 |
|---|---|---|---|---|
| Basic | 0.98 | 0.00 | 0.88 | 80% |
| Hybrid | 0.03 | 0.00 | 0.00 | 정보를 찾을 수 없음 |
| Rerank | 0.19 | 0.83 | 0.00 | 일부 정보만 답변 |
| Metadata-Full | 0.15 | 0.67 | 0.00 | 표에 정보가 없다고 답변 |
원인 분석
BM25가 추나요법, 디스크, 협착증 등의 키워드가 포함된 여러 연도의 문서를 함께 검색했습니다.
Hybrid 검색 결과에는 2020년부터 2026년까지 여러 연도의 추나요법 관련 표가 혼재했습니다.
Gemini는 여러 연도의 유사한 표 안에서 2026년 정보를 특정하지 못하고 정보를 찾을 수 없습니다라는 보수적인 응답을 생성했습니다.
Metadata-Full에서는 source_year="2026" 필터를 적용해 연도 혼동을 줄였습니다.
하지만 PDF 표가 일반 텍스트처럼 평탄화되어 단순추나, 특수추나, 질환 조건과 80%라는 셀의 관계를 정확히 인식하지 못했습니다.
Ragas 메트릭 충돌
Basic의 응답은 실제 정답인 80%였지만 Faithfulness는 0.00이었습니다.
Answer Correctness: 0.98
Faithfulness: 0.00
답변은 표의 여러 셀을 조합해 추론한 결과였습니다.
Ragas의 Faithfulness 평가 모델은 해당 값이 컨텍스트에 직접 기술된 문장이라고 인식하지 못해 근거 없음으로 평가했습니다.
이 사례는 표 데이터 기반 답변을 Faithfulness만으로 평가하기 어렵다는 점을 보여줍니다.
15. 실패 사례 B: Recall은 0이지만 Correctness가 유지된 q15
질문
2018년과 2026년 의료급여 정신질환 환자가
외래에서 처방받는 장기지속형 주사제의
본인부담률은 각각 얼마인가요?
기준 답안
2018년은 10%이고,
2026년은 2%입니다.
변형별 결과
| 변형 | Recall | Precision | Faithfulness | Correctness |
|---|---|---|---|---|
| Basic | 1.00 | 0.57 | 0.71 | 0.37 |
| Hybrid | 1.00 | 0.67 | 0.67 | 0.63 |
| Rerank | 0.00 | 0.79 | 0.50 | 0.37 |
| Metadata-Full | 0.00 | 0.95 | 0.75 | 0.64 |
Rerank에서는 Cohere Cross-encoder가 2018년의 장기지속형 주사제 10% 근거를 Top-10 밖으로 밀어냈습니다.
그 결과 Context Recall은 0.00이 되었습니다.
Metadata-Full에서도 2018년 문서는 후보에 포함되었지만 Re-ranking 이후 최종 컨텍스트에서 제외되었습니다.
그런데 Metadata-Full의 Answer Correctness는 0.64였습니다.
이는 2018년 답은 누락했지만 2026년의 2%는 정확하게 답해 부분 점수를 받았기 때문입니다.
Context Recall: 0.00
Answer Correctness: 0.64
Context Recall만 보면 완전한 검색 실패처럼 보이지만, Answer Correctness만 보면 어느 정도 성공한 것처럼 보입니다.
따라서 하나의 메트릭만으로 RAG의 성공 여부를 판단하면 잘못된 결론을 내릴 수 있습니다.
16. Ragas 메트릭으로 확인한 점
Context Recall이 1이어도 답변은 틀릴 수 있다
q02, q03, q08, q10의 Basic 결과에서는 Context Recall이 높았지만 답변이 정보를 찾을 수 없습니다였습니다.
Context Recall은 정답에 필요한 문서가 검색 결과 안에 존재하는지를 평가합니다.
LLM이 해당 정보를 실제로 읽고 올바르게 활용했는지는 평가하지 않습니다.
정답 문서 검색 성공
≠
정답 생성 성공
정보 없음 답변의 Faithfulness가 높을 수 있다
정보를 찾을 수 없습니다라는 답변은 컨텍스트에 없는 사실을 만들어 내지 않습니다.
따라서 Ragas는 해당 응답을 근거에서 벗어나지 않은 답변으로 판단하여 Faithfulness를 높게 평가할 수 있습니다.
하지만 사용자에게 유용한 답변은 아니므로 Answer Correctness와 함께 확인해야 합니다.
Faithfulness가 높아도 정답은 아닐 수 있다
Rerank는 가장 높은 Faithfulness인 0.837을 기록했습니다.
그러나 Answer Correctness는 Hybrid와 거의 같은 0.698이었습니다.
검색 문서에 충실한 답변이라고 해서 기준 답안과 반드시 일치하는 것은 아닙니다.
표 데이터는 별도 평가가 필요하다
의료급여 PDF의 핵심 정보는 표 형태로 작성되어 있습니다.
표의 행과 열을 조합해야 정답을 얻을 수 있는 경우, Ragas가 근거 문장을 직접 찾지 못해 Faithfulness를 낮게 평가할 수 있습니다.
표 기반 도메인에서는 일반 텍스트 중심 평가와 다른 메트릭이 필요합니다.
Cross-year 질문에는 연도 평가가 필요하다
Cross-year 질문에서는 두 연도의 정보가 모두 포함되어야 합니다.
현재 Ragas 기본 메트릭만으로는 특정 연도가 누락되었는지 명확하게 진단하기 어렵습니다.
답변에 포함된 연도와 값을 별도로 검사하는 YearAccuracy와 같은 커스텀 메트릭이 필요합니다.
17. 실습 중 발생한 문제
문제 1. LLM generation 수 경고
Answer Relevancy 평가 중 다음 경고가 반복적으로 발생했습니다.
LLM returned 1 generations
instead of requested 3ResponseRelevancy는 내부적으로 여러 역질문을 생성하고 임베딩 유사도를 계산합니다.
하지만 gpt-4o-mini가 세 개의 응답을 요청받아도 하나만 반환하는 경우가 있었습니다.
평가는 하나의 샘플로 계속 진행되었지만 Answer Relevancy 점수의 변동성이 커질 수 있다는 한계가 있습니다.
문제 2. Context Precision NaN
일부 문항에서 llm_context_precision_with_reference 결과가 NaN으로 저장되었습니다.
발생 문항은 다음과 같습니다.
- Basic
q04 - Basic
q06 - Hybrid
q06
평가 LLM이 판정을 완료하지 못하거나 빈 응답을 반환한 것이 원인으로 추정됩니다.
평균 계산에서는 NaN 값을 제외했습니다.
따라서 Context Precision의 변형별 평균은 서로 다른 유효 표본 수를 기준으로 계산되었습니다.
문제 3. Cohere Rate Limit
Rerank와 Metadata-Full 평가에서는 Cohere API의 무료 플랜 제한이 적용되었습니다.
10 requests per minute평가 중 Rate Limit 대기로 인해 변형별로 약 2분의 추가 시간이 발생했습니다.
정확도에는 영향을 주지 않았지만 대규모 평가를 반복할 경우 실행 시간과 비용을 함께 고려해야 합니다.
문제 4. 주석과 실제 모델 설정의 차이
evaluate_ragas.py의 일부 설명에는 평가 모델이 Claude Sonnet 4.5라고 작성되어 있었습니다.
하지만 실제 코드에서는 다음 모델을 사용했습니다.
DEFAULT_MODEL = "gpt-4o-mini"각 변형의 MEMO.md에서도 gpt-4o-mini를 사용한 것으로 확인했습니다.
따라서 실제 평가 결과는 gpt-4o-mini 기준으로 정리했습니다.
18. 개선해 보고 싶은 부분
YearAccuracy 커스텀 메트릭
Cross-year 답변에 필요한 연도와 값이 모두 포함되었는지 별도로 평가할 필요가 있습니다.
기준:
2018년 10%, 2026년 2%

응답:
2026년 2%
현재 Answer Correctness는 부분 점수를 부여하지만, 서비스 관점에서는 한쪽 연도가 누락된 불완전한 답변입니다.
TableAccuracy 커스텀 메트릭
표의 행, 열, 조건과 값을 구조적으로 비교하는 평가 메트릭이 필요합니다.
대상: 1종 수급권자
치료: 단순추나·특수추나
조건: 디스크·협착증 외
정답: 80%
각 조건과 셀 값이 정확히 일치하는지를 평가하면 일반 Faithfulness가 놓치는 표 기반 오류를 보완할 수 있습니다.
표 단위 Document 분리
현재 표는 페이지의 일반 텍스트와 함께 Markdown으로 저장됩니다.
표를 독립된 Document로 분리하고 다음과 같은 메타데이터를 추가할 수 있습니다.
{
    "doc_type": "table",
    "source_year": "2026",
    "page": 10,
}
표가 독립된 검색 단위가 되면 행과 열의 관계를 더 명확하게 유지할 수 있습니다.
Cross-year 연도별 후보 보장
두 연도를 비교하는 질문에서는 특정 연도의 문서가 Re-ranking 과정에서 모두 제거될 수 있습니다.
2018년 후보 5개
+
2026년 후보 5개
=
최종 Top-10
연도별 후보 개수를 강제로 보장하면 한쪽 연도의 근거가 누락되는 문제를 줄일 수 있습니다.
Query Rewriting
추상적으로 표현된 질문을 문서의 실제 용어와 가까운 검색어로 변환할 수 있습니다.
기존 질문:
입원 면제의 원칙적인 이유는?

검색용 질문:
의료급여 1종 수급권자
입원 본인부담금 면제 기준
평가 결과 시각화
현재 결과는 CSV와 Markdown 파일로 저장합니다.
다음 시각화를 추가하면 변형별 특징을 더 쉽게 비교할 수 있습니다.
- 메트릭별 막대그래프
- RAG 변형별 레이더 차트
- 문항별 히트맵
- 난이도별 Answer Correctness
- Recall과 Correctness 상관관계
Retrieval과 Generation 회귀 테스트 분리
현재는 전체 RAG 파이프라인을 한 번에 평가합니다.
검색 단계와 생성 단계를 별도로 테스트하면 코드 변경으로 인한 회귀를 더 정확하게 확인할 수 있습니다.
Retrieval 평가
→ 정답 문서 검색 여부

Generation 평가
→ 제공된 정답 문서로 올바른 답변을 생성하는지

End-to-End 평가
→ 실제 RAG 전체 결과
19. 느낀 점
4주차에서 정답과 오답 기준으로 평가했을 때는 Advanced 기법을 추가할수록 성능이 계속 향상되는 것처럼 보였습니다.
하지만 Ragas의 다섯 가지 메트릭으로 같은 결과를 분석하니 훨씬 복잡한 패턴을 확인할 수 있었습니다.
가장 인상적인 점은 Advanced 기법의 효과가 메트릭마다 다르다는 것이었습니다.
Context Precision과 Faithfulness는 Rerank 단계까지 계속 상승했습니다.
반면 Answer Correctness는 다음과 같이 Hybrid 이후 거의 변하지 않았습니다.
Hybrid: 0.699
Rerank: 0.698
Metadata-Full: 0.696
BM25를 추가하면서 정답 정확도의 대부분이 개선되었고, 이후의 Re-ranking과 Metadata Filter는 검색 정밀도와 근거 충실도를 개선했지만 최종 답변 정확도에는 큰 영향을 주지 않았습니다.
Ragas 메트릭과 실제 품질이 어긋나는 사례도 확인했습니다.
정보 없음답변의 Faithfulness가 높게 평가됨- 정답인 80% 답변의 Faithfulness가 0으로 평가됨
- Context Recall은 0이지만 Answer Correctness는 0.64를 기록함
이러한 결과를 통해 하나의 메트릭만으로 RAG 품질을 판단해서는 안 된다는 점을 알 수 있었습니다.
또한 검색과 Re-ranking을 개선하더라도 PDF 파싱 단계에서 표 구조가 손실되면 성능 향상에 한계가 있다는 점도 확인했습니다.
다음 개선 우선순위는 검색 후보를 더 늘리는 것이 아니라 표 구조를 보존하는 인덱싱 방식과 도메인에 적합한 평가 메트릭을 만드는 것입니다.
20. 핵심 정리
-
2016년부터 2026년까지 의료급여 PDF 11개를 하나의 ChromaDB에 인덱싱했습니다.
-
Basic, Hybrid, Rerank, Metadata-Full 네 가지 RAG 파이프라인을 동일한 15개 문항으로 평가했습니다.
-
Context Recall, Context Precision, Faithfulness, Answer Relevancy, Answer Correctness 메트릭을 사용했습니다.
-
생성용 LLM은 Gemini, 평가용 LLM은
gpt-4o-mini를 사용하여 생성과 평가 모델을 분리했습니다. -
Ragas의 평가 프롬프트를 한국어로 변환하여 적용했습니다.
-
Basic에서 Hybrid로 변경하면서 Faithfulness가 0.554에서 0.780으로 개선되었습니다.
-
Rerank는 Context Precision 0.941과 Faithfulness 0.837로 가장 높은 검색 정밀도와 근거 충실도를 기록했습니다.
-
Answer Correctness는 Hybrid 0.699, Rerank 0.698, Metadata-Full 0.696으로 거의 동일했습니다.
-
Re-ranking 과정에서 정답 청크가 제거되어 Context Recall이 낮아지는 사례가 발생했습니다.
-
Metadata Pre-filter가 연도 혼동을 줄였지만, 표 구조 문제까지 해결하지는 못했습니다.
-
정답 답변의 Faithfulness가 0이거나 정보 없음 답변의 Faithfulness가 높게 나오는 메트릭 충돌을 확인했습니다.
-
Cross-year 질문에는 연도별 답변 정확도를 검사하는 별도 메트릭이 필요했습니다.
-
표 기반 질문에는 일반 텍스트 중심 Faithfulness와 다른 평가 방식이 필요했습니다.
-
다음 개선 우선순위는 표 단위 문서 분리, YearAccuracy, TableAccuracy, Cross-year 연도별 후보 보장입니다.
참고 자료